24 out 2026 · ia, custo, observabilidade · 4 min
Custo por consumidor: quanto cada serviço gasta de modelo
Sem saber quem gasta, o custo de modelo vira surpresa no fim do mês. Registrar cada chamada com consumidor, modelo e dia, e agrupar, mostra onde o dinheiro vai. Na prática, a maior parte do gasto costuma estar num único consumidor.
O problema
Um agente, um bot e um script de resumo compartilham a mesma chave de API. No fim do mês a fatura chega, mas ninguém sabe quem pediu o quê. A conta não tem rótulo, só total.
A saída é registrar cada chamada com três campos além do modelo: quem chamou, quantos tokens e quanto custou. Com isso, um script agrupa por consumidor, modelo e dia, e o ranking aparece.
O formato do registro
Um arquivo JSONL, uma linha por chamada ou por lote. Campos mínimos:
{"ts": "2026-10-20T09:12:00Z", "consumer": "bot-telegram", "model": "gpt-4o-mini", "calls": 1, "prompt_tokens": 45000, "completion_tokens": 3000, "cost_usd": 0.0090}
ts aceita ISO 8601 ou epoch. calls é opcional e vale 1 por padrão. cost_usd é opcional; se faltar, o script soma zero e você calcula depois com a tabela de preços do provedor.
O artefato
#!/usr/bin/env python3
"""Agrupa gasto de modelo por consumidor, modelo e dia.

Lê um arquivo JSONL com um registro por chamada (ou por lote) e imprime
o ranking de consumidores e o detalhe por dia e modelo.

Campos aceitos em cada linha:
  ts ou date        instante (ISO 8601 ou epoch)
  consumer          nome do serviço ou tarefa que fez a chamada
  model             nome do modelo
  calls             quantas chamadas (opcional, padrão 1)
  prompt_tokens     tokens de entrada
  completion_tokens tokens de saída
  cost_usd          custo da chamada em dólares (opcional)

Uso:
  python3 custo_por_consumidor.py uso.jsonl
  python3 custo_por_consumidor.py            # roda com exemplo embutido
"""
import json
import sys
from collections import defaultdict
from datetime import datetime, timezone


def para_data(valor):
    if isinstance(valor, (int, float)):
        dt = datetime.fromtimestamp(valor, tz=timezone.utc)
    else:
        s = str(valor).strip()
        try:
            dt = datetime.fromisoformat(s.replace("Z", "+00:00"))
        except ValueError:
            dt = datetime.strptime(s[:10], "%Y-%m-%d").replace(tzinfo=timezone.utc)
    return dt.date().isoformat()


def carregar(caminho):
    with open(caminho, encoding="utf-8") as f:
        for linha in f:
            linha = linha.strip()
            if not linha:
                continue
            yield json.loads(linha)


EXEMPLO = [
    {"ts": "2026-10-20T09:12:00Z", "consumer": "bot-telegram", "model": "gpt-4o-mini",
     "calls": 1, "prompt_tokens": 45000, "completion_tokens": 3000, "cost_usd": 0.0090},
    {"ts": "2026-10-20T10:00:00Z", "consumer": "resumo-diario", "model": "gpt-4o-mini",
     "calls": 1, "prompt_tokens": 12000, "completion_tokens": 800, "cost_usd": 0.0024},
    {"ts": "2026-10-21T08:00:00Z", "consumer": "resumo-diario", "model": "gpt-4o-mini",
     "calls": 1, "prompt_tokens": 11000, "completion_tokens": 700, "cost_usd": 0.0022},
    {"ts": "2026-10-21T11:30:00Z", "consumer": "transcricao", "model": "whisper-1",
     "calls": 1, "prompt_tokens": 0, "completion_tokens": 0, "cost_usd": 0.0120},
    {"ts": "2026-10-22T14:00:00Z", "consumer": "bot-telegram", "model": "gpt-4o-mini",
     "calls": 1, "prompt_tokens": 60000, "completion_tokens": 4000, "cost_usd": 0.0120},
]


def main():
    if len(sys.argv) > 1:
        registros = list(carregar(sys.argv[1]))
    else:
        registros = EXEMPLO

    grupos = defaultdict(lambda: {"chamadas": 0, "prompt": 0,
                                 "completion": 0, "custo": 0.0})
    for r in registros:
        chave = (r.get("consumer", "?"), r.get("model", "?"),
                 para_data(r.get("ts") or r.get("date")))
        g = grupos[chave]
        g["chamadas"] += int(r.get("calls", 1) or 1)
        g["prompt"] += int(r.get("prompt_tokens", 0) or 0)
        g["completion"] += int(r.get("completion_tokens", 0) or 0)
        g["custo"] += float(r.get("cost_usd", 0) or 0)

    por_consumidor = defaultdict(lambda: {"chamadas": 0, "prompt": 0,
                                         "completion": 0, "custo": 0.0})
    for (consumidor, modelo, dia), g in grupos.items():
        c = por_consumidor[consumidor]
        c["chamadas"] += g["chamadas"]
        c["prompt"] += g["prompt"]
        c["completion"] += g["completion"]
        c["custo"] += g["custo"]

    print("CONSUMO POR CONSUMIDOR (total da janela)")
    print(f"{'consumidor':20} {'chamadas':>9} {'prompt':>10} "
          f"{'completion':>11} {'custo_usd':>10}")
    for consumidor, c in sorted(por_consumidor.items(),
                               key=lambda x: -x[1]["custo"]):
        print(f"{consumidor:20} {c['chamadas']:9} {c['prompt']:10} "
              f"{c['completion']:11} {c['custo']:10.4f}")

    print("\nDETALHE POR DIA E MODELO")
    for (consumidor, modelo, dia), g in sorted(grupos.items()):
        print(f"{dia}  {consumidor:20} {modelo:14} chamadas={g['chamadas']:4} "
              f"prompt={g['prompt']:8} completion={g['completion']:7} "
              f"custo={g['custo']:.4f}")

    total = sum(c["custo"] for c in por_consumidor.values())
    print(f"\nTOTAL: {len(registros)} registros, "
          f"{len(por_consumidor)} consumidores, "
          f"custo total = {total:.4f} USD")


if __name__ == "__main__":
    main()
Rode com seus dados:
python3 custo_por_consumidor.py uso.jsonl
Sem arquivo, roda com um exemplo embutido e imprime o mesmo formato.
Como registrar a chamada
Se você chama o provedor direto, envolva a chamada num wrapper que escreve a linha após a resposta. O objeto de resposta traz usage.prompt_tokens e usage.completion_tokens.
import json, time

def chamar(consumer, model, fn, *args, **kwargs):
    inicio = time.time()
    resp = fn(*args, **kwargs)
    uso = getattr(resp, "usage", None)
    registro = {
        "ts": time.strftime("%Y-%m-%dT%H:%M:%SZ", time.gmtime()),
        "consumer": consumer,
        "model": model,
        "calls": 1,
        "prompt_tokens": getattr(uso, "prompt_tokens", 0) if uso else 0,
        "completion_tokens": getattr(uso, "completion_tokens", 0) if uso else 0,
        "cost_usd": 0.0,
    }
    with open("uso.jsonl", "a", encoding="utf-8") as f:
        f.write(json.dumps(registro) + "\n")
    return resp
O cost_usd fica 0.0 e você preenche depois com a tabela de preços do provedor, ou calcula na hora se tiver o preço por mil tokens.
Como verificar
A saída esperada tem duas partes. Primeiro o ranking:
CONSUMO POR CONSUMIDOR (total da janela)
consumidor           chamadas     prompt  completion  custo_usd
bot-telegram                2     105000        7000     0.0210
transcricao                 1          0           0     0.0120
resumo-diario               2      23000        1500     0.0046

TOTAL: 5 registros, 3 consumidores, custo total = 0.0376 USD
Depois o detalhe por dia e modelo. Se os números batem com a fatura do provedor, o registro está certo.
Se der errado
KeyError: 'consumer'. Causa: alguma linha do JSONL não tem o campo. Correção: padronize o produtor para sempre escrever consumer, mesmo que seja "desconhecido".
json.decoder.JSONDecodeError. Causa: linha quebrada ou vírgula sobrando. Correção: valide o arquivo com python3 -m json.tool linha por linha, ou use jq -c ..
Totais não batem com a fatura. Causa: cache de tokens não registrado, ou custo calculado com preço errado. Correção: some cache_read_tokens e cache_write_tokens se o provedor cobrar por eles, e confira a tabela de preços na data da chamada.
Exemplo real
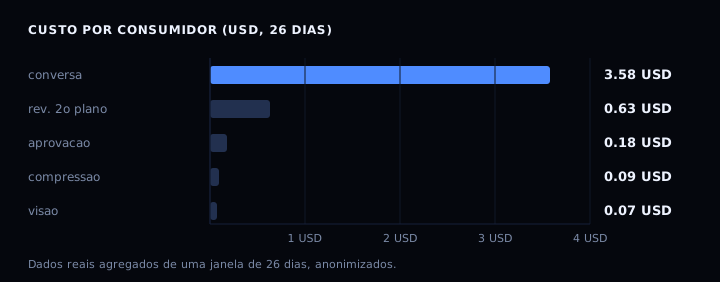
Numa janela de 26 dias, o maior consumidor foi a tarefa de conversa, com 4194 chamadas e 3,58 USD. O segundo foi a revisão em segundo plano, com 0,63 USD. O terceiro, aprovação, com 0,18 USD. O total da janela foi 4,55 USD.
FAQ
Preciso de um gateway como LiteLLM? Não para começar. O script lê o que você já registra. Um gateway centraliza e adiciona chave virtual por consumidor, o que ajuda quando o número de serviços cresce. Para poucos consumidores, o JSONL basta.
Como registrar se uso SDK direto? Envolva a chamada num wrapper que escreve a linha após a resposta. O objeto de resposta traz usage.prompt_tokens e usage.completion_tokens. O custo você calcula com o preço do modelo.
E se o provedor não retorna tokens? Estime: 1 token vale cerca de 4 caracteres em inglês e 3 em português. Marque como estimativa no campo cost_status.
Vale a pena otimizar o maior consumidor primeiro? Sim. A regra de Pareto vale aqui: o topo do ranking concentra o gasto. Reduzir o prompt do maior consumidor em 20% economiza mais do que cortar todos os outros.
E se eu tiver muitos consumidores? Agrupe por serviço, não por requisição. O ranking continua útil e o arquivo não explode. Para dezenas de serviços, um gateway centralizado facilita.
Como saber se a estimativa de tokens está certa? Compare com o tokenizer do provedor. Para português, 1 token vale cerca de 3 caracteres. Se a sua estimativa foge muito, ajuste o fator.
Fontes
Documentação do LiteLLM: docs.litellm.ai.
LiteLLM, gateway open source com rastreamento de gasto: https://github.com/BerriAI/litellm Boas práticas de produção da OpenAI: https://developers.openai.com/api/docs/guides/production-best-practices
Links internos: veja servidores MCP prontos e cron do jeito certo.