27 out 2026 · linux, container, namespace, cgroup · 4 min
Contêiner não é máquina virtual: o que ele realmente é
Um contêiner não é uma máquina virtual. Não tem kernel próprio, não tem init system, não emula hardware. É um processo comum do Linux que vê um conjunto diferente de namespaces e um limite de cgroup. Tudo o que você chama de “contêiner” cabe numa linha: clone() com flags CLONE_NEWPID, CLONE_NEWNS, CLONE_NEWNET e um cgroup aplicado ao processo. O resto é empacotamento.
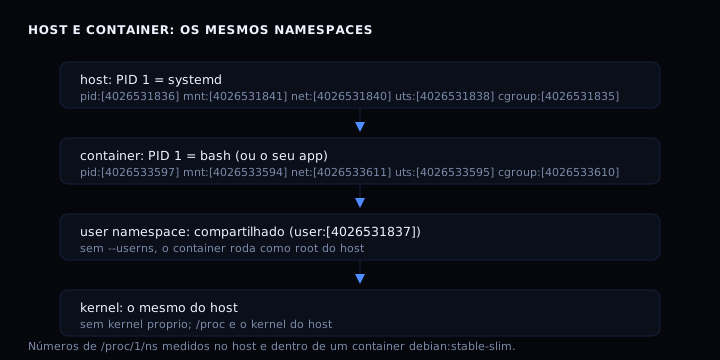
O que muda de fato
Três coisas separam um contêiner de um processo normal:
- Namespaces: o processo vê uma tabela de processos, uma rede, um hostname e um sistema de arquivos próprios. O kernel ainda é o mesmo do host.
- Cgroup: o processo tem limite de CPU, memória e I/O imposto pelo kernel. Sem cgroup, não há limite.
- Imagem: o sistema de arquivos do processo vem de uma imagem (camadas de arquivos), montada num namespace de mount. É só um diretório com arquivos, não um disco virtual.
O que não muda: o kernel, as chamadas de sistema, a segurança. Um contêiner é um processo do host com visão restrita. Se o kernel tem uma falha, o contêiner não protege.
O experimento
Rode o script abaixo onde você estiver (host ou contêiner). Ele imprime namespaces, cgroup, rede e processos visíveis do processo atual, sem depender de docker:
#!/usr/bin/env bash
# inspecionar-namespace.sh
echo "PID 1: $(cat /proc/1/comm) ($(tr '\0' ' ' < /proc/1/cmdline))"
echo "este processo: $$ ($(tr '\0' ' ' < /proc/$$/cmdline))"
echo "hostname: $(hostname)"
echo "kernel: $(uname -r)"
echo "cgroup: $(cat /proc/self/cgroup)"
echo "namespaces:"; ls -l /proc/self/ns
echo "interfaces:"; cat /proc/net/dev
echo "processos visiveis: $(ls /proc | grep -cE '^[0-9]+$')"
Para comparar host e contêiner, rode o mesmo script dentro de um contêiner. Se o docker estiver instalado, use:
docker run --rm -it debian:stable-slim bash -c '
echo "PID 1: $(cat /proc/1/comm)"
echo "hostname: $(hostname)"
echo "kernel: $(uname -r)"
echo "cgroup: $(cat /proc/1/cgroup)"
echo "namespaces:"; ls -l /proc/1/ns
echo "interfaces:"; cat /proc/net/dev
echo "processos visiveis: $(ls /proc | grep -cE "^[0-9]+$")"
'
O que você vê:
- PID 1: no host é
systemd; no contêiner é o processo que você lançou (oubash, se for o caso). O contêiner acha que é o primeiro processo do sistema. - Hostname: diferente, porque o namespace UTS isolou o nome.
- Interfaces: no host, todas; no contêiner, só
lo(com--network none) ou uma interface virtual (com bridge). O namespace de rede isolou a pilha. - Namespaces: os números entre colchetes (
pid:[...],mnt:[...],net:[...]) diferem entre host e contêiner. Isso é o isolamento. Ouser:[...]é igual: o user namespace não é isolado por padrão, e o root do contêiner é o root do host. - Processos visíveis: centenas no host, poucos no contêiner. O namespace de PID filtrou a visão.
- Kernel: o mesmo número de versão. Não há kernel próprio.
Como verificar
Rode os dois blocos e confira:
uname -ré igual nos dois. Se for diferente, você está numa VM, não num contêiner.- O número de
net:[...]difere. Se for igual, o contêiner compartilha a rede do host (--network host). - O
user:[...]é igual nos dois. Se for diferente, você ativou user namespace (--userns-remap), o que muda a segurança.
Se der errado
- “Permission denied” em
/proc/1/ns: o arquivo é legível só por root. Rode comsudoou use/proc/self/ns, que é do próprio processo. ls /proc/1/nsnão existe: kernel antigo (antes de 3.8) ou container runtime antigo. Atualize o kernel.- Contêiner não mostra isolamento: você usou
--privilegedou--pid host/--net host. Aí não há isolamento por design.
Contêiner, VM e processo: a tabela
| Característica | Processo normal | Contêiner | Máquina virtual |
|---|---|---|---|
| Kernel | compartilhado com o host | compartilhado com o host | próprio (guest) |
| PID 1 | init do host | processo do contêiner | init do guest |
| Isolamento de rede | não | namespace de rede | interface virtual + NAT |
| Sistema de arquivos | o do host | camadas de imagem | disco virtual |
| Limite de recursos | cgroup (se configurado) | cgroup (sempre) | hypervisor |
| Tempo de boot | imediato | segundos | minutos |
| Overhead de memória | nenhum | baixo | alto (kernel guest) |
FAQ
Contêiner é mais seguro que VM? Não. VM isola kernel; contêiner isola apenas o que o kernel permite isolar. Um escape de contêiner compromete o host. VM exige escape do hypervisor, que é uma superfície menor.
Posso rodar kernel diferente num contêiner? Não. O kernel é do host. Para kernel diferente, use VM.
Docker é o único jeito de fazer contêiner? Não. Docker usa as mesmas primitivas do kernel (namespaces, cgroups, overlayfs). Podman, containerd, LXC e systemd-nspawn fazem o mesmo. A diferença é a experiência de usuário, não a tecnologia.
O que é o “runtime” do contêiner?
O programa que chama as syscalls de namespace e cgroup para você. runc é o mais comum. O Docker é um cliente que fala com um daemon que chama o runtime.
Fontes: namespaces(7), cgroups(7). Links internos: contêiner sem root, docker limites de memória, docker compose do zero, o que são cgroups.