14 out 2026 · inteligencia artificial, infraestrutura, testes · 6 min
Como saber se o modelo piorou depois da troca
Trocar a versao do modelo e facil, comparar as duas e chato. A resposta curta: monte um conjunto pequeno de perguntas com resposta conferivel, rode o mesmo conjunto na versao antiga e na nova varias vezes, e compare a faixa, nao o numero solitario.
O mesmo modelo, na mesma versao, da placares diferentes a cada rodada. Nao e mudanca de comportamento: e o conjunto respondendo a hora do dia, a carga da maquina e o humor estocastico da amostra.
O conjunto: 20 perguntas que da para conferir
Cada pergunta tem uma resposta que se verifica sem opinionar: aritmetica, sequencia, unidades, data, hexadecimal, XOR, SQL, regex, shell, status HTTP. Nada de “escreva um poema sobre o mar”, que nao tem resposta certa e faz quem avalia julgar estilo em vez de acerto.
O script vem com as 20 embutidas e a regra de conferencia em cada linha. Duas delas:
("p01", "aritmetica",
 "Calcule 47 * 83 - 19. Responda so com o numero.",
 "numero=3882"),
("p11", "regex",
 "Escreva apenas a expressao regular que casa um IP v4 como 192.168.0.1, "
 "sem outros caracteres.",
 "regex-ip"),
A regra regex-ip merece explicacao, porque e a armadilha mais chata de um conjunto desse. Julgar a regex pela forma do texto reprova resposta certa: tanto \d quanto [0-9] casam um IP valido. O jeito certo e compilar a expressao que o modelo devolveu e testar o comportamento:
def regex_para_ip(expressao: str) -> bool:
    padrao = expressao.strip().strip("`")
    try:
        rx = re.compile(padrao)
    except re.error:
        return False
    return bool(rx.fullmatch("192.168.0.1")) and not rx.match("192.168.0.1x") \
        and not rx.match("999.1.1.1")
Isso evitou reprovar os dois modelos numa pergunta que eles responderam certo.
O script
Salve como avaliacao.py. Nao instala nada, so usa a biblioteca padrao. O BASE_URL e argumento, porque a pergunta nao e sobre modelo nenhum.
#!/usr/bin/env python3
"""avaliacao.py: 20 perguntas de resposta conferivel, rodadas repetidas e comparacao.

A ideia e simples: um placar so nao diz nada. O mesmo modelo, na mesma versao,
erra em perguntas diferentes a cada rodada. Entao o script roda o conjunto N vezes
por modelo, guarda cada rodada em um arquivo, e a comparacao mostra a faixa,
nao so o ultimo numero.

    export CHAVE_API="sua-chave"
    python3 avaliacao.py rodar gpt-4o-mini --rodadas 3
    python3 avaliacao.py rodar llama-3.1-8b --rodadas 3
    python3 avaliacao.py comparar

O BASE_URL e o MODELO sao argumentos, porque a pergunta nao e sobre modelo nenhum:
e sobre ter um metodo antes de trocar de versao.
"""
from __future__ import annotations

import argparse
import glob
import json
import os
import pathlib
import re
import statistics
import sys
import time
import unicodedata
import urllib.error
import urllib.request

BASE_URL = os.environ.get("BASE_URL", "https://api.openai.com/v1")
# Orcamento generoso de proposito: com 900 tokens o raciocinio do modelo consome
# tudo e a resposta volta vazia com finish_reason "length". Isso acontecia em
# 3 das 20 perguntas na medicao deste texto.
MAX_TOKENS = 4000

# --------------------------------------------------------------- o conjunto
# Cada linha traz a resposta conferivel. "contem" ignora acento e caixa.
PERGUNTAS = [
    ("p01", "aritmetica",
     "Calcule 47 * 83 - 19. Responda so com o numero.",
     "numero=3882"),
    ("p02", "ordenacao",
     "Ordene estes numeros do menor para o maior e responda so com eles, separados por "
     "virgula: 91, 17, 4, 63, 28, 55",
     "numero=4, 17, 28, 55, 63, 91"),
    ("p03", "sequencia",
     "Complete a sequencia e responda so com o proximo numero: 2, 6, 18, 54, 162, ...",
     "numero=486"),
    ("p04", "unidades",
     "Um processo consome 2,5 GB de RAM, e 1 GB vale 1000 MB. Quantos MB sao isso? "
     "Responda so com o numero.",
     "numero=2500"),
    ("p05", "data",
     "Quantos dias tem o mes de fevereiro de 2028, ano bissexto? Responda so com o numero.",
     "numero=29"),
    ("p06", "premissa",
     "Se todo retangulo tem quatro lados, e esta figura e um retangulo, quantos lados "
     "ela tem? Responda so com o numero.",
     "numero=4"),
    ("p07", "prosao",
     "Quantos segundos tem 15 minutos? Responda so com o numero.",
     "numero=900"),
    ("p08", "percentual",
     "De 1200 requisicoes, 47 por cento falharam. Quantas requisicoes falharam? "
     "Responda so com o numero.",
     "numero=564"),
    ("p09", "texto",
     "Qual destes e um comando que existe no coreutils do Linux: 'troca-tudo' ou 'cp'? "
     "Responda so com o comando.",
     "contem=cp"),
    ("p10", "sql",
     "Escreva apenas o comando SQL que lista as 10 contas com maior gasto da tabela "
     "conta(id, nome, gasto). Sem explicacao.",
     "contem=order by"),
    ("p11", "regex",
     "Escreva apenas a expressao regular que casa um IP v4 como 192.168.0.1, "
     "sem outros caracteres.",
     "regex-ip"),
    ("p12", "shell",
     "Escreva apenas o comando bash que mostra as 5 maiores linhas de tamanho em bytes "
     "de todos os .log do diretorio atual.",
     "contem=sort"),
    ("p13", "bits",
     "Quantos bytes tem 1 GiB, considerando 1 GiB = 2 elevado a 30? Responda so com "
     "o numero.",
     "numero=1073741824"),
    ("p14", "geometria",
     "Um retangulo tem area 240 cm2 e largura 15 cm. Quanto mede o comprimento, em cm? "
     "Responda so com o numero.",
     "numero=16"),
    ("p15", "bits",
     "Em hexadecimal, quanto e 255 mais 1? Responda so com o valor em hexadecimal, "
     "precedido de 0x.",
     "numero=0x100"),
    ("p16", "bits",
     "Quanto e 1234 XOR 5678, em decimal? Responda so com o numero.",
     "numero=4860"),
    ("p17", "shell",
     "Escreva apenas o comando shell que conta quantas linhas do arquivo access.log "
     "contem a palavra ' 500 '. Sem explicacao.",
     "contem=grep"),
    ("p18", "http",
     "Qual codigo de status HTTP significa 'Sem Autorizacao'? Responda so com o numero.",
     "numero=401"),
    ("p19", "logica",
     "Se chove, o cha fica molhado. Hoje o cha esta seco. Choveu hoje? "
     "Responda apenas 'sim' ou 'nao'.",
     "contem=nao"),
    ("p20", "inversao",
     "Inverta a ordem destes quatro termos e responda so com eles, separados por virgula: "
     "chave publica, hash, chave privada, assinatura",
     "contem=assinatura, chave privada, hash, chave publica"),
]


def normaliza(texto: str) -> str:
    """Minuscula, sem acento, espacos colapsados e sem espaco em volta de virgula.

    O espaco depois da virgula nao pode decidir ponto: o mesmo modelo responde
    '4,17,28' numa rodada e '4, 17, 28' na outra, e a resposta e a mesma.
    """
    n = unicodedata.normalize("NFD", texto.lower())
    n = "".join(c for c in n if unicodedata.category(c) != "Mn")
    n = re.sub(r"\s+", " ", n)
    n = re.sub(r"\s*,\s*", ",", n)
    return n.strip()


def regex_para_ip(expressao: str) -> bool:
    """A resposta para a p11 e certa se casar 192.168.0.1, recusar 999.1.1.1 e recusar
    192.168.0.1x. Julgar pela forma do texto reprova resposta certa: tanto \\d quanto
    [0-9] casam IP, e na medicao deste texto os dois modelos responderam certo."""
    padrao = expressao.strip().strip("`")
    try:
        rx = re.compile(padrao)
    except re.error:
        return False
    return bool(rx.fullmatch("192.168.0.1")) and not rx.match("192.168.0.1x") \
        and not rx.match("999.1.1.1")


def conferivel(regra: str, texto: str) -> bool:
    if regra == "regex-ip":
        return regex_para_ip(texto)
    return normaliza(regra.split("=", 1)[1]) in normaliza(texto)


def uma_rodada(modelo: str, base: str, chave: str, cabecalhos: dict[str, str],
               max_tokens: int) -> dict:
    acertos, disciplina, falhas, sem_resposta = 0, {}, [], []
    for pid, _categoria, pergunta, regra in PERGUNTAS:
        t0 = time.monotonic()
        try:
            cabec = {"Authorization": f"Bearer {chave}",
                     "Content-Type": "application/json", **cabecalhos}
            corpo = json.dumps({
                "model": modelo,
                "messages": [{"role": "user", "content": pergunta}],
                "temperature": 0,
                "max_tokens": max_tokens,
            }).encode()
            pedido = urllib.request.Request(
                f"{base.rstrip('/')}/chat/completions", data=corpo, headers=cabec)
            with urllib.request.urlopen(pedido, timeout=180) as r:
                d = json.load(r)
        except urllib.error.HTTPError as e:
            falhas.append(f"{pid}: HTTP {e.code} "
                          f"{e.read()[:80].decode(errors='replace').strip()}")
            disciplina[pid] = "erro"
            continue
        except Exception as e:  # noqa: BLE001
            falhas.append(f"{pid}: {type(e).__name__} {e}")
            disciplina[pid] = "erro"
            continue
        escolha = (d.get("choices") or [{}])[0]
        texto = ((escolha.get("message") or {}).get("content") or "").strip()
        if conferivel(regra, texto):
            acertos += 1
            disciplina[pid] = "ok"
        elif escolha.get("finish_reason") == "length" and not texto:
            # o modelo gastou o orcamento inteiro pensando e nao sobrou resposta
            disciplina[pid] = "sem-resposta"
            sem_resposta.append(pid)
        else:
            disciplina[pid] = "errou"
        del t0
    return {"acertos": acertos, "de": len(PERGUNTAS), "disciplina": disciplina,
            "falhas_api": falhas, "sem_resposta": sem_resposta}


def cmd_rodar(args) -> int:
    chave = args.chave or os.environ.get("CHAVE_API", "")
    if not chave:
        print("avaliacao.py: falta a chave. Faca assim:")
        print("  export CHAVE_API=\"sua-chave\"")
        print("  python3 avaliacao.py rodar MODELO_ANTIGO --rodadas 3")
        print("  python3 avaliacao.py rodar MODELO_NOVO   --rodadas 3")
        print("  python3 avaliacao.py comparar")
        return 1
    cabecalhos = {}
    for bruto in args.cabecalho:
        if ":" not in bruto:
            print(f"cabecalho invalido, use 'Nome: valor': {bruto}")
            return 1
        nome, valor = bruto.split(":", 1)
        cabecalhos[nome.strip()] = valor.strip()
    rodadas = []
    for n in range(1, args.rodadas + 1):
        print(f"  rodada {n}/{args.rodadas} de {args.modelo} ...", flush=True)
        r = uma_rodada(args.modelo, args.base, chave, cabecalhos, args.max_tokens)
        rodadas.append(r)
        extra = ""
        if r["falhas_api"] or r["sem_resposta"]:
            extra = (f", {len(r['falhas_api'])} falha(s) de API"
                     + (f", {len(r['sem_resposta'])} sem resposta" if r["sem_resposta"] else ""))
        print(f"    {r['acertos']}/{len(PERGUNTAS)}{extra}", flush=True)
        time.sleep(args.pausa)
    arquivo = pathlib.Path(f"avaliacao-{args.modelo.replace('/', '_')}.json")
    arquivo.write_text(json.dumps(
        {"modelo": args.modelo, "base": args.base, "rodadas": rodadas},
        ensure_ascii=False, indent=1), encoding="utf-8")
    notas = [r["acertos"] for r in rodadas]
    erros = sum(len(r["falhas_api"]) for r in rodadas)
    print(f"\n{args.modelo}: {notas}")
    print(f"  media {statistics.mean(notas):.1f}  "
          f"min {min(notas)}  max {max(notas)}  desvio {statistics.pstdev(notas):.1f}")
    print(f"  falhas de API somando as rodadas: {erros}")
    if erros:
        print("  PLACAR INVALIDO: com chamada falhando, o numero mede a sua rede, nao o modelo")
        for falha in rodadas[0]["falhas_api"][:1]:
            print(f"  primeiro erro: {falha}")
        print("  se o provedor pedir cabecalho extra, use --cabecalho \"Nome: valor\"")
    print(f"  gravado em {arquivo}")
    return 0


def cmd_comparar(args) -> int:
    arquivos = sorted(glob.glob("avaliacao-*.json"))
    if not arquivos:
        print("nenhum arquivo avaliacao-*.json ainda. Rode uma vez em cada modelo:")
        print("  CHAVE_API=\"sua-chave\" python3 avaliacao.py rodar MODELO_ANTIGO --rodadas 3")
        print("  CHAVE_API=\"sua-chave\" python3 avaliacao.py rodar MODELO_NOVO   --rodadas 3")
        print("  python3 avaliacao.py comparar")
        return 0
    print(f"{'modelo':28} {'rodadas':>18} {'media':>6} {'min':>4} {'max':>4} "
          f"{'desvio':>7} {'erros':>6}")
    resumo = []
    for arq in arquivos:
        d = json.loads(pathlib.Path(arq).read_text(encoding="utf-8"))
        notas = [r["acertos"] for r in d["rodadas"]]
        erros = sum(len(r.get("falhas_api", [])) for r in d["rodadas"])
        media = statistics.mean(notas)
        desvio = statistics.pstdev(notas) if len(notas) > 1 else 0.0
        resumo.append((d["modelo"], media, min(notas), max(notas), desvio, notas, erros))
        print(f"{d['modelo'][:28]:28} {str(notas):>18} {media:6.1f} {min(notas):4} "
              f"{max(notas):4} {desvio:7.1f} {erros:6}")
    print()
    for modelo, media, _mn, _mx, _desvio, notas, erros in resumo:
        print(f"  {modelo}: media {media:.1f}, cada rodada foi {notas}"
              + ("  INVALIDO" if erros else ""))
    if len(resumo) == 2:
        a, b = resumo
        print()
        if a[6] or b[6]:
            print("  uma das rodadas teve chamada falhando: a diferenca mede a rede, "
                  "nao os modelos")
        elif abs(a[1] - b[1]) <= max(a[4], b[4]):
            print(f"  diferenca de {abs(a[1] - b[1]):.1f} pontos, folga de ruido "
                  f"{max(a[4], b[4]):.1f}: INDISTINGUIVEL com estas rodadas")
        else:
            print(f"  diferenca de {abs(a[1] - b[1]):.1f} pontos acima da folga de "
                  f"{max(a[4], b[4]):.1f}: diferenca real")
        print("  para fechar: mais rodadas nos dois, e so se a diferenca continuar acima "
              "da folga vale concluir")
    return 0


def main() -> int:
    ap = argparse.ArgumentParser(description="20 perguntas conferiveis para comparar modelos")
    ap.add_argument("--chave", default="", help="ou use CHAVE_API no ambiente")
    ap.add_argument("--base", default=BASE_URL, help=f"padrao {BASE_URL}")
    ap.add_argument("--cabecalho", action="append", default=[],
                    help="'Nome: valor', repetivel")
    ap.add_argument("--max-tokens", type=int, default=MAX_TOKENS)
    sub = ap.add_subparsers(dest="cmd")
    r = sub.add_parser("rodar", help="roda o conjunto contra um modelo")
    r.add_argument("modelo")
    r.add_argument("--rodadas", type=int, default=3)
    r.add_argument("--pausa", type=float, default=1.0)
    r.set_defaults(func=cmd_rodar)
    c = sub.add_parser("comparar", help="compara os arquivos ja gravados")
    c.set_defaults(func=cmd_comparar)
    args = ap.parse_args()
    if not getattr(args, "func", None):
        # sem subcomando o script ainda tem de responder algo util, em vez de sair calado
        ap.print_help()
        print()
        print("comeco:")
        print("  export CHAVE_API=\"sua-chave\"")
        print("  python3 avaliacao.py rodar MODELO_ANTIGO --rodadas 3")
        print("  python3 avaliacao.py rodar MODELO_NOVO   --rodadas 3")
        print("  python3 avaliacao.py comparar")
        return 0
    return args.func(args)


if __name__ == "__main__":
    sys.exit(main())```

Como rodar, nos dois modelos e depois comparando:

```bash
export CHAVE_API="sua-chave"
python3 avaliacao.py rodar MODELO_ANTIGO --rodadas 3
python3 avaliacao.py rodar MODELO_NOVO   --rodadas 3
python3 avaliacao.py comparar
O que a medicao deu
Rodei as 20 perguntas em dois modelos, 3 rodadas cada, 120 chamadas, nenhuma falhou. Com o teto padrao de 4000 tokens, os dois fizeram 20 de 20 nas tres rodadas. O conjunto chegou ao topo e nao separou ninguem, e esse e o resultado honesto: 20 perguntas assim nao servem para escolher entre esses dois modelos.
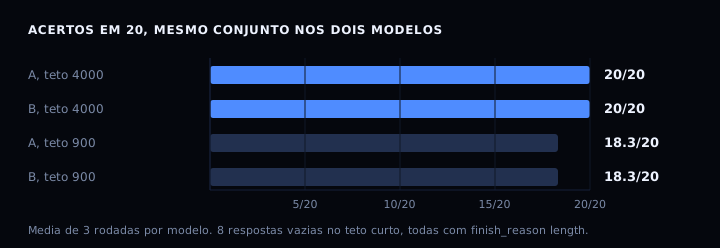
O parametro que mais mudou o placar foi outro. Com teto de 900 tokens, a media dos dois caiu para 18,3 e apareceram 8 respostas vazias, todas com finish_reason igual a length: o modelo gastou o orcamento pensando e nao sobrou texto, como descreve a documentacao do endpoint. Compare versoes com teto curto e parte da diferenca que voce atribui ao modelo e do seu parametro.
Como verificar
O comando e a saida esperada com os dois modelos rodados:
python3 avaliacao.py comparar
modelo                                  rodadas  media  min  max  desvio  erros
cat-jam-free                       [20, 20, 20]   20.0   20   20     0.0      0
space-bunny                       [20, 20, 20]   20.0   20   20     0.0      0

  cat-jam-free: media 20.0, cada rodada foi [20, 20, 20]
  space-bunny: media 20.0, cada rodada foi [20, 20, 20]

  diferenca de 0.0 pontos, folga de ruido 0.0: INDISTINGUIVEL com estas rodadas
A coluna erros e a primeira que voce olha: ela soma as chamadas que falharam, e um placar com chamada falhando mede a sua rede, nao o modelo. Na primeira versao do meu script isso nao aparecia, e o resultado foi 0 de 20 sem explicacao, porque toda chamada tinha falhado.
Para ver a faixa de ruido de um modelo so, mude o numero de rodadas:
python3 avaliacao.py rodar MODELO --rodadas 5
Se der errado
Todas as chamadas falham com HTTP 400 e a mensagem MissingSessionID. Esse gateway exige cabecalho de sessao alem da chave: passe com --cabecalho "x-opencode-session: minha-sessao". Sem ele o script marca tudo como erro e avisa que o placar e invalido.
Duas rodadas dao numeros bem diferentes. E o normal, e a razao de existirem varias rodadas. Suba para 5 e compare a media com a faixa.
O modelo acerta e o script marca errado. A regra esta estreita demais, e isso aconteceu comigo em duas perguntas antes de acertar o conjunto: uma regra que exigia \d reprovou uma regex certa com [0-9], e uma premissa falsa de aranha media discordancia, nao qualidade. Antes de culpar o modelo, teste o conferidor com uma resposta que voce sabe estar certa.
Comparacao das formas de comparar
| forma | o que mede | custo | quando usar |
|---|---|---|---|
| um placar so | o ultimo sorteio | 1 rodada | so como palpite |
| media de 3 rodadas | media e desvio | 3 rodadas | comparacao de rotina |
| 20 perguntas conferiveis | acerto objetivo | 20 chamadas | padrao minimo |
| conjunto do seu dominio | o que importa | escrito por voce | tarefa especifica |
| LLM como juiz | estilo e qualidade | caro e subjetivo | criterio escrito antes |
Um conjunto do seu dominio vale mais que qualquer generico. As 20 perguntas aqui mostram o metodo; para o seu servico, escreva 20 perguntas dele e rode o mesmo script.
FAQ
Preciso de 20 perguntas? Menos que 10 nao separa modelo: o desvio de uma rodada ja come a diferenca que voce quer medir. Acima de 30 o custo pesa, e vale escolher as perguntas mais proximas do seu uso.
Como sei que a diferenca que achei e real? So depois de repetir e ela continuar acima do desvio. Com 3 rodadas, 1 ponto contra um desvio de 0,8 nao fecha nada. O script avisa isso em texto para ninguem pular essa parte.
Mudo o conjunto e o modelo junto, preciso refazer? Sim, e o conjunto antigo perde valor. A comparacao so vale com as perguntas fixas entre as duas versoes.
Isso funciona com qualquer provedor? Com qualquer endpoint compativel com chat completion: o BASE_URL e argumento por isso. Alguns gateways exigem cabecalho extra, e o script tem --cabecalho.
E as perguntas com resposta aberta? Nao entram aqui. Resposta aberta exige criterio escrito antes, e em geral isso vira julgamento humano, mais lento e mais caro que ler tres rodadas de placar. O caminho, se quiser medir assim, e um conjunto do seu dominio com resposta esperada.
Fontes
- Referencia do endpoint de chat, OpenAI, conferida em 14 out 2026. A definicao de
finish_reasonigual alength. - Working with evals, OpenAI, conferida em 14 out 2026. Descrever a tarefa antes de medir, e o aviso de descontinuacao.
- Praticas de avaliacao, OpenAI, conferida em 14 out 2026. Os cinco passos de desenho e o alerta sobre nao determinismo.
Quem ja mediu custo por consumidor e quer somar isso ao metodo, veja o que da para medir na propria maquina. E quem ainda compara versao por sentinela, trocar a senha do servidor por chave SSH mostra o outro lado: trocar sem medir e o jeito mais rapido de descobrir que voce regrediu.