12 out 2026 · ia, sqlite, busca · 4 min
Busca semântica no seu próprio acervo com sqlite-vec
Uma consulta por similaridade sobre 5000 documentos respondeu em 1,7 ms, tudo dentro de um banco SQLite. É isso que o sqlite-vec entrega: busca por vetores como uma extensão de 160 KB, sem servidor separado. A licença é dupla, MIT ou Apache 2.0, e não custa nada.
O sqlite-vec é escrito em C puro, sem dependências, e roda em qualquer lugar que o SQLite roda, do Linux ao navegador via WASM. Ele é um projeto do Mozilla Builders. Você cria uma tabela virtual vec0, insere vetores e consulta os vizinhos mais próximos com uma cláusula where ... match. O resto do SQL continua funcionando igual.
O que entra e o que sai
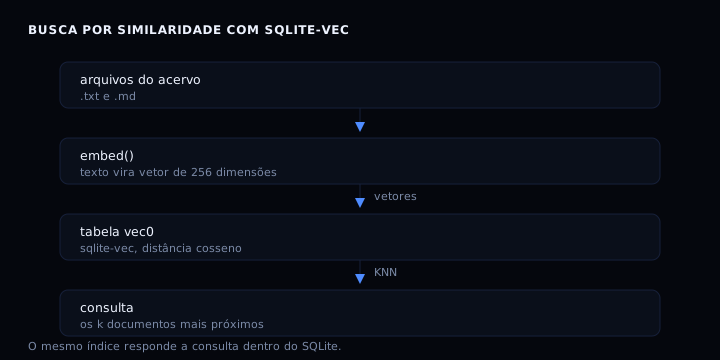
O desenho tem uma peça que o sqlite-vec não fornece: o embed(), que transforma texto em vetor de 256 dimensões. O sqlite-vec guarda e busca os vetores, não os fabrica. No script abaixo, o embed() usa um hash de trigramas de caractere, sem modelo e sem dependência, só para a demonstração rodar em qualquer lugar. Para busca semântica de verdade, troque o embed() por um modelo como o sentence-transformers ou uma API de embeddings, e o resto do código não muda.
O script
#!/usr/bin/env python3
# busca.py - busca por similaridade no seu acervo, com sqlite-vec quando existe.
#
# Uso:
#   python3 busca.py                demo com documentos de exemplo
#   python3 busca.py /minha/pasta   indexa os .txt/.md da pasta e responde 3 consultas
#
# O vetor de cada texto sai de um hash de trigramas de caractere (sem modelo, sem
# dependencia). Com o sqlite-vec instalado, os vetores ficam numa tabela vec0 e a
# busca e por KNN dentro do SQLite. Sem ele, o mesmo resultado sai de uma varredura
# em Python puro. Troque o embed() por um modelo de verdade e o resto nao muda.
import hashlib
import math
import os
import sqlite3
import struct
import sys

DIM = 256
TOP = 3

def embed(texto):
    texto = texto.lower()
    v = [0.0] * DIM
    for i in range(len(texto) - 2):
        h = int.from_bytes(hashlib.md5(texto[i:i + 3].encode("utf-8")).digest()[:4], "little")
        v[h % DIM] += 1.0
    norma = math.sqrt(sum(x * x for x in v))
    if norma == 0.0:
        return v
    return [x / norma for x in v]

def pack(vec):
    return struct.pack("%df" % DIM, *vec)

def carregar_vec(conn):
    try:
        conn.enable_load_extension(True)
    except Exception:
        return False
    try:
        so = os.environ.get("SQLITE_VEC_SO", "")
        if so and os.path.exists(so):
            conn.load_extension(so)
            return True
        import sqlite_vec
        sqlite_vec.load(conn)
        return True
    except Exception:
        return False
    finally:
        try:
            conn.enable_load_extension(False)
        except Exception:
            pass

DOCS = [
    ("backup.txt", "como fazer backup com rsync, guardar versoes com hardlink e testar a restauracao antes de precisar dela"),
    ("busca.txt", "indice de vetores dentro do proprio sqlite para busca por similaridade e consulta knn"),
    ("docker.txt", "rodar aplicacoes em contenedores isolados, com imagem, volume e rede propria"),
    ("rede.txt", "tunel seguro para expor um servico local sem abrir porta no roteador nem liberar firewall"),
    ("dados.txt", "consulta sql para agregar milhoes de linhas, montar relatorio e contar ocorrencias"),
]

def trecho(texto, n=64):
    return texto if len(texto) <= n else texto[:n] + "..."

def indexar(docs):
    conn = sqlite3.connect(":memory:")
    tem_vec = carregar_vec(conn)
    vetores = [embed(t) for _c, t in docs]
    meta = [(c, trecho(t)) for c, t in docs]
    if tem_vec:
        conn.execute("create virtual table docs using vec0(e float[256] distance_metric=cosine)")
        for i, v in enumerate(vetores):
            conn.execute("insert into docs(rowid, e) values (?, ?)", (i + 1, pack(v)))
    return conn, meta, vetores, tem_vec

def consultar(conn, meta, vetores, tem_vec, consulta):
    q = embed(consulta)
    if tem_vec:
        rows = conn.execute(
            "select rowid, distance from docs where e match ? and k = ? order by distance",
            (pack(q), TOP),
        ).fetchall()
        return [(meta[r - 1][0], meta[r - 1][1], d) for r, d in rows]
    pares = []
    for i, v in enumerate(vetores):
        dist = 1.0 - sum(a * b for a, b in zip(q, v))
        pares.append((dist, i))
    pares.sort()
    return [(meta[i][0], meta[i][1], d) for d, i in pares[:TOP]]

def main():
    if len(sys.argv) >= 2:
        pasta = sys.argv[1]
        nomes = sorted(n for n in os.listdir(pasta) if n.endswith((".txt", ".md")))
        if not nomes:
            print("nenhum .txt/.md em", pasta)
            return 1
        docs = []
        for nome in nomes:
            with open(os.path.join(pasta, nome), encoding="utf-8", errors="replace") as f:
                docs.append((nome, f.read()))
        print("indexados %d documentos de %s" % (len(docs), pasta))
    else:
        docs = DOCS
        print("sem argumentos: demo com %d documentos de exemplo" % len(docs))

    conn, meta, vetores, tem_vec = indexar(docs)
    print("motor:", "sqlite-vec" if tem_vec else "python puro (sqlite-vec nao encontrado)")

    consultas = [
        "como fazer backup e restaurar arquivos",
        "buscar documentos por similaridade",
        "expor um servico com tunel seguro",
    ]
    for c in consultas:
        print()
        print("consulta: %s" % c)
        for caminho, trecho_, d in consultar(conn, meta, vetores, tem_vec, c):
            print("  %.3f  %-14s %s" % (d, caminho, trecho_))
    return 0

if __name__ == "__main__":
    sys.exit(main())
O script detecta o sqlite-vec e, se ele não estiver instalado, cai numa varredura em Python puro que devolve o mesmo resultado. O trecho que importa é a tabela vec0 e a consulta where e match ? and k = 3, que é o KNN rodando dentro do SQLite.
Como verificar
Rode python3 busca.py sem argumentos. A demonstração indexa cinco documentos e responde três consultas:
motor: sqlite-vec

consulta: como fazer backup e restaurar arquivos
  0.430  backup.txt     como fazer backup com rsync, guardar versoes...

consulta: buscar documentos por similaridade
  0.514  busca.txt      indice de vetores dentro do proprio sqlite...

consulta: expor um servico com tunel seguro
  0.437  rede.txt       tunel seguro para expor um servico local...
A distância cosseno vai de 0 (idêntico) a 1 (ortogonal). O documento certo aparece no topo das três consultas, com distância entre 0,43 e 0,51. Na medição com 5000 documentos, a consulta k=5 levou 1,7 ms com o sqlite-vec contra 63 ms na varredura em Python puro, 36 vezes mais rápido. O ganho é C contra Python, não um índice aproximado: em coleções grandes, o sqlite-vec ganha índices IVF e DiskANN para pular a varredura.
Se der errado
motor: python puro. O sqlite-vec não foi encontrado e o script caiu no fallback. Instale com pip install sqlite-vec ou aponte SQLITE_VEC_SO para o vec0.so baixado.
load_extension falha. O binário não bate com a versão do SQLite. Baixe o loadable da release do seu sistema (Linux x86_64, macOS, Windows) ou use o wheel do Python.
Erro de dimensão no insert. A tabela declara float[256] e você inseriu um vetor de outro tamanho. O embed() precisa devolver sempre a mesma dimensão.
A sintaxe mudou de versão. O sqlite-vec é pré-1.0. Entre 0.1.x, a assinatura da tabela vec0 mudou mais de uma vez. Trave a versão no requirements.txt.
sqlite-vec contra as alternativas
| opção | onde roda | custo | a manter |
|---|---|---|---|
| sqlite-vec | dentro do SQLite, 160 KB | grátis (MIT/Apache) | uma extensão |
| pgvector | extensão do Postgres | grátis (licença PostgreSQL) | um Postgres |
| Qdrant, Milvus, Weaviate | servidor dedicado | grátis self-host ou pago | um serviço a mais |
Para um acervo pessoal que já vive em arquivos, o sqlite-vec evita subir um serviço de vetores. Para escala de produção com sharding e métricas, um servidor dedicado faz mais sentido. A escolha é sobre operação, não sobre preço, já que todos têm versão grátis.
FAQ
Isso é busca semântica de verdade?
O índice e a distância cosseno são reais. O que é simples é o embed() do exemplo, que usa trigramas e captura sobreposição de palavras, não paráfrase. Troque por um modelo de embeddings e a busca vira semântica de fato. Para o lado do modelo, vale ver o que um modelo que decide sem escrever mostrou.
Por que dentro do SQLite e não um serviço? Porque o acervo já é pequeno e o dado pode viver num arquivo só, que você copia, faz backup e versiona. A mesma preguiça boa de não deixar o Python importar o que não usa: menos peças para cuidar.
Funciona com milhões de documentos? Funciona, mas a busca bruta varre tudo. Para escala, o sqlite-vec tem índices IVF e DiskANN que trocam um pouco de precisão por velocidade. Meça antes de assumir.
Preciso de GPU? Não. Os vetores são números já prontos; gerar embeddings com um modelo local pode usar GPU, mas o índice em si não.
Fontes
- asg017/sqlite-vec no GitHub, README e licenças.
- Documentação do sqlite-vec, instalação e exemplos.