09 out 2026 · inteligência artificial · 6 min
Jev: o modelo que não escreve texto e decide em milissegundos
O que é, em um parágrafo
Jev é um modelo lançado em 15 de setembro de 2026 pela TypeSafe AI, startup do Diogo Almeida, um dos autores do artigo que originou o ajuste de instrução do ChatGPT. Ele não gera texto. Você entrega um estado (um texto, um JSON, uma linha de tabela) e uma lista de perguntas com respostas possíveis já definidas, e ele devolve uma resposta tipada com a probabilidade associada. A empresa chama a categoria de “System One Model”, em referência ao pensamento rápido e intuitivo descrito por Daniel Kahneman, em oposição ao raciocínio lento que os modelos de conversa fazem ao escrever.
Atualização: três semanas depois, auditorias independentes mediram o modelo em dados públicos, e alguns números contrariam o anúncio. Estão em Jev, três semanas depois.
Por que existe
Boa parte do trabalho que se tenta delegar a um modelo de linguagem não é escrever, é decidir: classificar um chamado, dizer se uma mensagem é tentativa de golpe, escolher o próximo passo de um agente, dar uma nota de risco. Para esse tipo de tarefa, pedir um parágrafo de justificativa é caro e lento, e ainda obriga o programa a interpretar texto livre para descobrir a decisão.
A proposta do Jev é inversa: a decisão sai pronta para o código consumir, com um número de confiança ao lado. Segundo a TypeSafe, o treino usa um método próprio, o RLCD (Reinforcement Learning for Calibrated Decisions), que otimiza a calibração em vez da preferência humana: se o modelo diz 80% de chance, o objetivo é que ele acerte em cerca de 80% dos casos ao longo do tempo. Isso é diferente do RLHF, que é treinado para produzir a resposta que um humano prefere.
As três respostas possíveis
Toda pergunta feita ao modelo cai em um destes formatos, e nada mais:
| tipo | o que devolve | exemplo de pergunta |
|---|---|---|
| escolha | uma opção entre as que você listou, com a probabilidade de cada uma | “esta mensagem é sobre pagamento, suporte, cancelamento ou vendas?” |
| nota | um valor dentro de uma escala que você define | “de 0 a 4, qual a urgência deste chamado?” |
| proposição | a probabilidade de uma afirmação ser verdadeira, entre 0 e 1 | “este e-mail é uma tentativa de golpe?” |
Não existe campo de texto livre na resposta. É isso que permite dizer que o formato não tem como sair errado: o conjunto de saídas já estava definido antes da chamada.
Como usar
O acesso é por API. O ponto de entrada documentado é uma chamada POST para https://api.typesafe.ai/v1/systemone, com o modelo jev-latest. O exemplo abaixo é ilustrativo, para mostrar a forma do pedido; confira o formato exato na documentação da TypeSafe antes de integrar.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "Cliente relata que o boleto de setembro veio com valor diferente do contrato e pede correção imediata.",
    "questions": [
      {"id": "assunto", "type": "choice", "options": ["cobranca", "suporte", "cancelamento", "vendas"]},
      {"id": "urgencia", "type": "score", "min": 0, "max": 4},
      {"id": "risco_de_cancelamento", "type": "proposition", "statement": "O cliente corre risco de cancelar nos próximos 30 dias"}
    ]
  }'
O programa que chamou recebe as decisões com as probabilidades e decide o que fazer. O modelo não escreve o e-mail de resposta nem o texto do ticket; isso continua sendo trabalho de um modelo de conversa, quando for necessário.
Onde ele encaixa bem
- Triagem de atendimento. Classificar e priorizar a fila antes de qualquer redação. É o caso mais citado na documentação e nas análises publicadas.
- Guarda-corpo de agente. Antes de um agente executar uma ação, perguntar se a ação é compatível com o pedido. Uma resposta booleana rápida é mais útil que um parágrafo de análise no caminho crítico.
- Verificação de saída. Checar se o texto produzido por outro modelo cumpre uma condição (por exemplo, se cita o preço correto) e devolver aprovado ou reprovado.
- Classificação em volume. Etiquetar linhas de uma base grande de textos, onde o custo por decisão decide se o projeto cabe no orçamento.
- Moderação e filtros. Decidir o que passa, o que vai para revisão humana e o que é bloqueado.
Onde ele não encaixa
- Gerar texto, explicar, resumir ou conversar. Não é o que ele faz.
- Decisão que exige raciocínio longo e aberto, com passos e justificativa escrita.
- Pergunta cujo conjunto de respostas não pode ser definido antes. Se a resposta possível não caber em uma lista, o Jev não é a ferramenta.
Comparação com um modelo de conversa
| Jev | modelo de conversa | |
|---|---|---|
| saída | valor tipado, já utilizável pelo código | texto que precisa ser interpretado |
| latência publicada | 70 a 500 ms | segundos por resposta de alguns parágrafos |
| cobrança | por token de entrada, saída sem cobrança | entrada e saída cobradas |
| formato | definido na chamada, sem variação | livre, sujeito a variação |
| ponto fraco | não escreve, não explica, depende da calibração | custo e latência por chamada, e a decisão precisa ser extraída do texto |
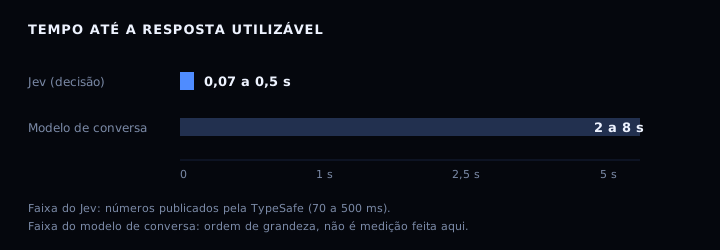
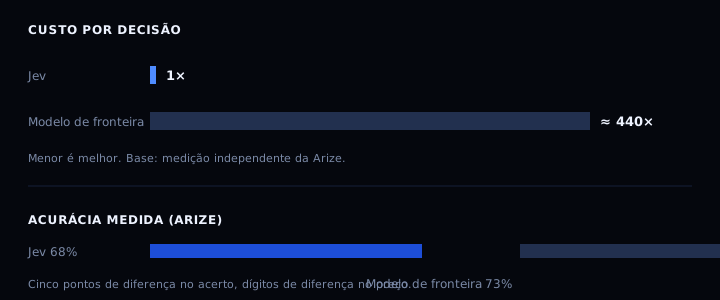
Os números de latência e custo acima são os divulgados pela TypeSafe. A Arize publicou uma medição independente que coloca a acurácia do Jev em 68%, contra 73% de um modelo de fronteira da mesma geração, e destaca o custo como o ponto central: a diferença de acerto é pequena perto da diferença de preço por decisão.
Como eu avaliaria antes de adotar
- Monte um conjunto de perguntas fechadas, com respostas corretas já conhecidas, tiradas do seu próprio histórico.
- Meça acerto e calibração, não só acerto: se o modelo diz 0,9, quantas vezes acertou? Um modelo confiante e errado é pior que um incerto.
- Compare o custo por decisão com o de um modelo de conversa no mesmo conjunto.
- Verifique se a decisão está no caminho crítico do usuário. Se estiver, latência de milissegundos muda o desenho da aplicação; se não estiver, o ganho é só de custo.
- Só depois escolha onde usar. Ferramenta nova não vira arquitetura no primeiro dia.
O ecossistema em volta
O lançamento veio com integração no AI Gateway da Vercel, que relatou uso de quase 13% dos times pagantes nas primeiras 24 horas. Em duas semanas apareceram projetos abertos que treinam modelos para o mesmo formato, como o OpenJev, e bibliotecas de medição de calibração, como o AnyJev. Também existe a crítica recorrente, de parte da área de aprendizado de máquina, de que a função do Jev se parece com a de classificadores e cross-encoders que já existiam; o que mudou foi o preço e a latência, não a ideia.
Vale acompanhar com ceticismo saudável: os números de velocidade e custo são da empresa que vende o modelo, e a adoção ainda é recente.
Links
- Documentação da TypeSafe: docs.typesafe.ai
- O que é Jev, pela Vercel: vercel.com
- Medição independente de acurácia e custo, pela Arize: arize.com
- Guia prático de uso, no DEV: dev.to
- Explicação técnica, na DataCamp: datacamp.com
- Explicação em português: tecedi.com.br
- Análise do ecossistema aberto que surgiu em duas semanas: note.com
- OpenJev (projeto aberto): github.com
- AnyJev (medição de calibração): pypi.org