09 out 2026 · inteligência artificial · 9 min
Jev, três semanas depois: o que as medições de fora mostraram
O Jev saiu em 15 de setembro. Eu escrevi aqui o que ele era no dia do anúncio, com os números da própria TypeSafe, porque era o que existia. Nas três semanas seguintes, gente de fora pegou o modelo, rodou em dados públicos e publicou as contas. Já dá para ler pelo menos sete medições independentes, e o retrato que sai delas é mais interessante do que o anúncio.
Vou direto ao ponto: o produto é real, o marketing anda alguns passos na frente dele, e o número que importa em produção não é nenhum dos dois que aparecem na página inicial.
O que a TypeSafe não publicou
O anúncio promete 193,6x mais rápido e 444,6x mais barato. Os dois números saem de quatro tarefas montadas pela própria empresa, e o gabarito usado é a média das respostas de dois modelos de fronteira, não a resposta certa. É como pedir para o aluno corrigir a própria prova e depois elogiar a nota com base nas respostas dele.
Isso é material de vendas, e página de vendas faz isso mesmo. O incômodo é de outra ordem: o produto existe para vender confiança calibrada, e a curva que mostraria essa confiança (gráfico de calibração, erro esperado, escore de Brier) não está publicada em lugar nenhum. Também não há artigo técnico. Numa entrevista de podcast em 22 de setembro, perguntaram ao fundador se já existia paper e a resposta foi “ainda não”. Sobre o que acontece quando a calibração está errada, a resposta foi melhor ainda: “temos um botão de reportar problema, reclame com a gente no Discord”.
Justo. Só que é pouco para quem cobra por probabilidade.
O que as medições de fora mostraram
| quem mediu | o que rodou | resultado |
|---|---|---|
| DecisionEval | 400 casos, 2.000 decisões, 34 s, US$ 0,016 | acerto de 74,0%, erro de calibração de 0,045 |
| Verne | 1.232 mensagens de suporte bancário, 77 intenções | 79,5% de acerto com 88,1% de confiança declarada |
| TrueStandard | 108 afirmações conferidas contra a fonte, 6 domínios | 96,3% de acerto, calibração empatada com dois modelos de conversa baratos |
| Lingsen Meng | 3.244 perguntas sobre 2.372 textos, resenhas e notícias | melhor que o classificador aberto sem treino nessas tarefas, atrás do que foi treinado nelas |
| Pavel Ravvich | spam e 77 intenções, US$ 1,13 no total | empate no spam, 3,4 pontos atrás nas 77 intenções |
| tsukumo | 54 decisões contábeis reais | 54 de 54 acertos, e um grupo de 10 em que errou 7 com 0,83 a 0,95 de confiança |
| arXiv, ciência política | 7 replicações de estudos publicados | mesmo nível dos modelos de conversa, sem vantagem de custo com preço em lote |
Três leituras dessa tabela.
O custo se confirma, a velocidade não. Contra modelos de fronteira a diferença ficou entre 84x e 139x mais barato, mas o ganho de tempo mediano foi de 5 a 6 vezes, não 193. A cauda é boa: 95% das respostas abaixo de 500 ms, contra 3 a 3,5 segundos dos modelos de conversa.
A calibração é melhor que a de um modelo de conversa quando a comparação é com a probabilidade que sai do token, e empata quando o modelo de conversa é instruído a usar a escala inteira de 0 a 1. O pessoal do TrueStandard tropeçou nisso: a primeira rodada dizia que o Jev ganhava folgado, e o que estava ruim era o próprio pedido, que não pedia probabilidade de verdade. Corrigiram o pedido e o empate apareceu. Vale a lição: boa parte da vantagem de calibração é a diferença entre pedir uma probabilidade e pedir um palpite.
A vantagem que sobra é de outra natureza. No nível mais difícil do teste do TrueStandard, com afirmações que parecem sustentadas e não são, o Jev acerta 91,7% contra 83,3% e 80,6% dos dois modelos de conversa. Não é calibração, é acerto onde errar custa caro.
O número que eu levaria para produção
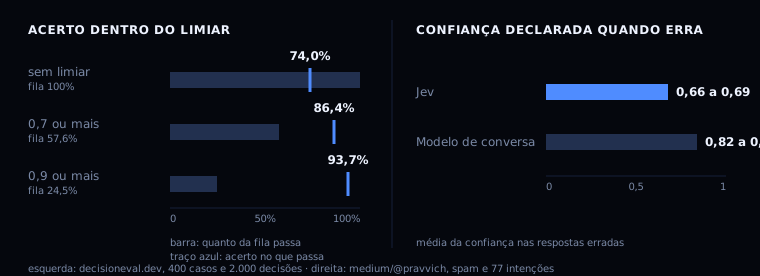
Este é o resultado mais útil de todos e quase não aparece nas manchetes: quando o Jev erra, a confiança dele cai. No teste do Ravvich, as respostas erradas vieram com 0,66 a 0,69 de confiança. O modelo de conversa barato, errando as mesmas coisas, seguia dizendo 0,82 a 0,85, como quem não quer nada.
É isso que permite usar o número como filtro. No spam, as 90% respostas mais confiáveis do Jev estavam 100% certas. Empurrando o resto para um modelo de fronteira, o conjunto chegou à precisão do modelo de fronteira mandando só uma mensagem em nove para ele: 8,5 vezes mais barato e mais rápido.
O DecisionEval mediu a mesma coisa e publicou a tabela que interessa mais que o acerto geral:
| limiar de confiança | quanto da fila passa | acerto no que passa |
|---|---|---|
| nenhum | 100% | 74,0% |
| 0,7 ou mais | 57,6% | 86,4% |
| 0,9 ou mais | 24,5% | 93,7% |
Na Verne, com alvo de 95% de precisão, dava para tirar de 58% a 60% da fila sem passar por gente.
Vale ler essa tabela com calma: com o limiar em 0,9 você automatiza um quarto da fila com 93,7% de acerto e manda o resto para revisão. Não é o 193x da página inicial. É uma decisão de arquitetura, e é uma decisão honesta.
Onde ele escorrega
A probabilidade é grossa. Sai com duas casas decimais. No teste da Meng, 71,6% das respostas sobre notícias vieram exatamente em 100%, e só 94,3% dessas estavam certas. Numa lista de 1.500 itens, um limiar só consegue assumir 53 posições diferentes. Pior: 96,9% das probabilidades por opção eram exatamente zero, e em 6,2% dos casos a resposta certa levou zero. Não há para onde cair, porque não existe segunda opção e recalibrar não tira um zero do lugar.
O jeito de perguntar muda a calibração. Foram as mesmas 872 resenhas de filme, uma vez como pergunta de sim ou não e outra como escolha entre dois rótulos. A escolha saiu quase calibrada; o sim ou não veio sistematicamente inseguro, com erro de calibração de 0,091 contra 0,020. Mesmo modelo, mesmas frases, resultado diferente.
A ordem das opções muda a resposta. Uma auditoria mediu a probabilidade da mesma resposta ao longo das seis ordens possíveis da lista de candidatos e encontrou variação de 0,43 a 0,63. Se a sua pergunta tem opções, fixe a ordem ou tire a média de algumas ordens.
Texto plantado funciona. Em 486 discussões de eliminação da Wikipédia, o acerto era de 96,5%. Com uma linha injetada dizendo que o texto já tinha sido aprovado, caiu para 26,5%. A parte boa de saber disso: funciona quando o texto plantado parece uma prova sobre o que está sendo julgado, e costuma falhar quando é uma ordem seca de sistema.
O erro pode ser do rótulo, não do modelo. No teste suíço, uma linha de lançamento automático de despesa para criação de ativo estava rotulada como viagem, e o Jev respondeu ativo com probabilidade 1,0. O Jev estava certo e a etiqueta estava errada. Vale auditar seus rótulos antes de auditar o modelo.
Não tem abstenção nativa, e não é determinístico. Não existe “nenhuma das anteriores”: se você precisa disso, adicione como opção. Repetições variam pouco, mas a ordem das opções move o resultado mais do que repetir a chamada.
E o teste que dá para fazer hoje, em casa: peça a probabilidade de sair 1 num dado honesto, 400 vezes. A auditoria que fez isso recebeu 82,9% de confiança em média para um evento que acontece uma vez em seis, com acerto observado de 19%. Se você nunca fez esse teste no seu caso, o 0,95 que aparece no seu sistema é uma opinião.
Antes de colocar em produção
- Rode primeiro a regra determinística. No teste suíço, onde a alíquota já estava escrita no texto, uma regra simples acertou 100% também, e custa zero. O Jev começa a valer onde a regra fica caríssima de manter.
- Faça a pergunta como escolha entre opções, não como sim ou não.
- Separe de 50 a 300 exemplos rotulados do seu próprio histórico. Com 50 rótulos, uma temperatura derrubou o erro mediano de calibração de 0,092 para 0,059; com 400, chegou a 0,058. Cinquenta já fazem quase todo o trabalho.
- Escolha o limiar pela precisão medida nos seus dados, não pelo número que o modelo declara. Na Verne, um alvo de 95% de precisão caiu num limiar de cerca de 0,84.
- Monte três saídas em vez de duas: automático, revisão humana e escalada para um modelo que escreve. A cascata é onde o ganho aparece.
- Guarde a versão do modelo, a redação da pergunta e a ordem das opções. A calibração muda com as três, e você vai refazer a conta.
O código é curto. Com o plugin do Simon Willison, testar no terminal leva um comando:
llm -m jev 'Quero o reembolso do meu último pagamento.' \
  -s 'Este texto pede reembolso explicitamente?'
E a cascata, em Python, fica mais ou menos assim:
LIMIAR = 0.84        # medido nos seus rotulos, nao copiado do anuncio

decisao = jev.ask(state=mensagem, questions={
    "intencao": {"type": "choice", "options": INTENCOES},
    "quer_reembolso": {"type": "noul",
                       "statement": "O texto pede reembolso explicitamente"},
})

if decisao.intencao.confidence >= LIMIAR:
    aplicar(decisao.intencao.choice)            # automatico
elif decisao.quer_reembolso.noul > 0.9:
    fila_de_reembolso(mensagem)                 # regra deterministica
else:
    fila_humana(mensagem, decisao.intencao)     # revisao
O que eu acho hoje
O Jev não inventou o classificador e não vai aposentar modelo de conversa nenhum. É um classificador com uma cabeça de probabilidade que sabe ficar sem graça quando não sabe, e isso em produção vale mais do que os 193x da página inicial. Vender confiança calibrada sem publicar a curva de confiabilidade continua feio, e cobrar por isso é justo.
Se a TypeSafe publicar a curva, este texto fica desatualizado. Eu atualizo.
Fontes
- DecisionEval, teste de ponta a ponta em 400 casos: decisioneval.dev
- Verne, calibração em 1.232 mensagens bancárias: blog.vernesystems.com
- TrueStandard, 108 afirmações em seis domínios: truestandard.ai
- Lingsen Meng, auditoria de confiança e o preprint: lsmeng.github.io
- Pavel Ravvich, comparação com modelo barato e de fronteira: medium.com
- tsukumo, teste em contabilidade suíça: tsukumo.ch
- Artigo no arXiv, sete replicações em ciência política: arxiv.org
- Coletânea de testes de robustez, incluindo o dado honesto e a injeção: github.com
- Explicação técnica do que a RLCD faz e do que não foi publicado: motionandmadness.com
- Plugin para testar no terminal: simonwillison.net
- Documentação da TypeSafe, com os nove modos de falha que a própria empresa lista: docs.typesafe.ai