29 out 2026 · ia, custo, llm · 5 min
Quanto custa um milhão de tokens
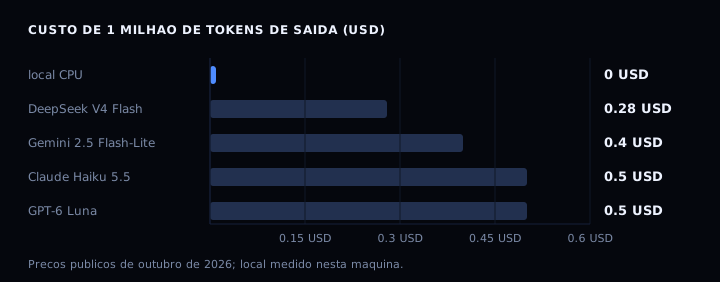
A conta de um milhão de tokens depende mais do modelo do que do volume. Em outubro de 2026, a distância entre a opção mais barata e a mais cara é de duas ordens de grandeza para o mesmo milhão de tokens de saída. Medição própria numa CPU comum: o modelo qwen2.5:0.5b rodando em Ollama gerou 23,8 tokens por segundo, ou 11,7 horas para um milhão de tokens. O custo local é o hardware e a eletricidade, não o token.
O que a tabela mede
Os preços abaixo são por um milhão de tokens de saída (output), que é onde a conta pesa. Token de entrada custa de três a dez vezes menos na maioria dos provedores, e cache de prompt corta ainda mais. A tabela não inclui taxa de requisição, armazenamento de cache nem custo de embedding.
| Opção | Saída por 1M tokens | Observação |
|---|---|---|
| Local, qwen2.5:0.5b em CPU | US$ 0 | hardware já pago; 23,8 tok/s medidos |
| DeepSeek V4 Flash | US$ 0,28 | cache hit a US$ 0,0028 |
| Gemini 2.5 Flash-Lite | US$ 0,40 | tier gratuito com limite diário |
| Claude Haiku 5.5 | US$ 0,50 | abaixo de 100k tokens por requisição |
| GPT-6 Luna | US$ 0,50 | entrada a US$ 0,10 |
Para comparação, um modelo de ponta como GPT-6 Astra cobra US$ 50,00 por milhão de tokens de saída. A diferença entre o mais barato e o mais caro é de cem vezes. A maioria das aplicações não precisa do mais caro para a maior parte das chamadas.
A medição local
Rodei o modelo qwen2.5:0.5b no Ollama dentro de um contêiner, com a API local, pedindo 300 tokens de saída. Três execuções deram entre 22,7 e 23,8 tokens por segundo. Usei 23,8 como referência. A conta é direta: um milhão dividido por 23,8 dá 42.016 segundos, ou 11,7 horas. Numa CPU de quatro núcleos sem GPU.
Esse número é o teto do que cabe numa máquina pequena. Modelos maiores caem para 2 a 5 tokens por segundo na mesma CPU, e aí o milhão de tokens vira dias. A troca é qualidade: o qwen2.5:0.5b responde curto e erra em tarefa longa. Para classificação, extração de campo e resumo curto ele serve. Para código longo ou raciocínio, não.
O que ninguém coloca na conta
- Energia e refrigeração do host, se o modelo roda 24 horas por dia.
- A RAM ocupada pelo modelo, que deixa de servir outra coisa. O qwen2.5:0.5b ocupa cerca de 400 MB em memória.
- O tempo de engenharia para manter o serviço no ar, atualizar modelo e lidar com queda.
- A latência: 23,8 tokens por segundo é lento para chat interativo, mas aceitável para lote.
Por isso a comparação justa não é só preço por token. É preço por token mais o custo de operar. Para baixo volume, o provedor ganha. Para alto volume e tarefa simples, o local ganha, desde que a equipe aceite operar o serviço.
Como decidir
Comece pela tarefa, não pelo preço. Se a tarefa aceita modelo pequeno, teste local primeiro e meça tokens por segundo na sua máquina, como fiz aqui. Se a tarefa exige modelo grande, calcule o volume mensal e multiplique pelo preço de saída do provedor. O ponto de virada costuma aparecer entre 10 e 50 milhões de tokens por mês para um modelo de classe Haiku.
Para controlar custo em provedor, use cache de prompt, saída curta e modelo mais fraco na primeira tentativa. O custo por consumidor de IA mostra como atribuir a conta a quem consome. Para medir o que o modelo consome de RAM no host, veja medir memória de um processo.
Como verificar
curl -s -X POST http://127.0.0.1:11434/api/generate \
  -d '{"model":"qwen2.5:0.5b","prompt":"Explique o que e um container Linux.","stream":false,"options":{"num_predict":300}}' \
  | jq '{tokens: .eval_count, segundos: (.eval_duration/1000000000), tok_s: (.eval_count/(.eval_duration/1000000000))}'
Saída esperada: cerca de 300 tokens, 12,6 segundos e 23,8 tokens por segundo. A sua máquina pode variar, mas não por muito.
Se der errado
connection refusedna porta 11434: o Ollama não está rodando. Suba comollama serveou use o contêiner.model not found: baixe comollama pull qwen2.5:0.5b.- Número muito abaixo de 20 tok/s: a CPU está ocupada por outro processo ou a memória está no limite. Feche cargas e tente de novo.
- JSON sem
eval_count: a resposta foi em streaming. Garanta"stream":false.
FAQ
Um milhão de tokens é muito? Depende. Um chat de suporte com 500 interações por dia e 2.000 tokens por interação passa de 30 milhões por mês. Um script que roda uma vez por dia pode usar 10 mil.
Token de entrada e saída custam o mesmo? Não. Saída custa de três a dez vezes mais. Um prompt longo com resposta curta é barato; o contrário não.
Vale a pena rodar modelo local em produção? Para tarefa simples e alto volume, sim. Para tarefa complexa e baixo volume, o provedor é mais barato quando se conta o tempo de operação. Meça os dois antes de decidir.
E o custo de cache de prompt? DeepSeek cobra US$ 0,0028 por milhão de tokens em cache hit. Anthropic e OpenAI têm desconto similar. Se o mesmo prefixo se repete, o cache muda a conta.
Como comparar modelos de tamanhos diferentes? Não compare só preço. Um modelo de US$ 0,50 pode precisar de duas chamadas para acertar o que um de US$ 5 acerta de primeira. Meça acerto e custo total da tarefa, não por token.
Fontes
- OpenAI API pricing, consultado em 29 de outubro de 2026.
- DeepSeek platform, consultado em 29 de outubro de 2026.
- Gemini Developer API pricing, consultado em 29 de outubro de 2026.
- Claude pricing, consultado em 29 de outubro de 2026.