05 nov 2026 · ia, voz · 5 min
piper: texto em fala rodando na sua máquina
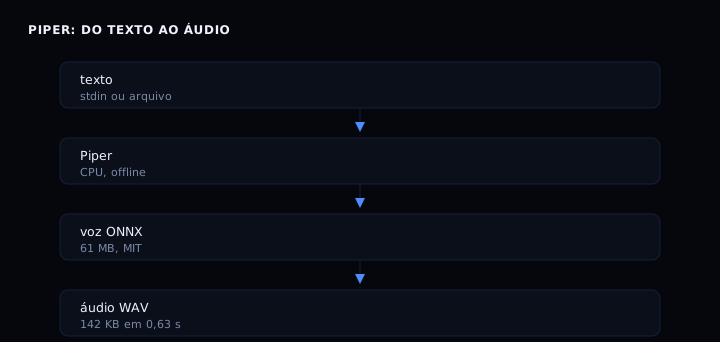
Piper é um sintetizador de voz neural que roda na sua máquina, sem GPU e sem internet depois do download. Você passa o texto, ele devolve um arquivo WAV. A voz pesa 61 MB e uma frase de três segundos sai em 0,63 s.
O projeto nasceu no rhasspy/piper (licença MIT). O desenvolvimento migrou para o OHF-Voice/piper1-gpl (GPL-3.0). As vozes, no repositório rhasspy/piper-voices no Hugging Face, são MIT. Para uso comercial, confira a licença do binário que você escolher.
O script abaixo baixa a voz pt_BR-faber-medium, gera áudio para três frases e imprime o tamanho e o tempo de cada uma. Se o piper não estiver instalado, ele imprime as instruções e sai sem erro.
#!/usr/bin/env bash
# piper-gerar.sh
# Baixa uma voz pt_BR e gera áudio para frases de exemplo.

set -u

VOZ="${VOZ:-pt_BR-faber-medium}"
VOZ_URL="https://huggingface.co/rhasspy/piper-voices/resolve/main/pt/pt_BR/faber/medium"
DESTINO="${DESTINO:-./piper-vozes}"
PIPER_BIN="${PIPER_BIN:-piper}"

if ! command -v "$PIPER_BIN" >/dev/null 2>&1 && [ ! -x "./piper/piper" ]; then
  echo "piper não encontrado."
  echo "Baixe o binário em https://github.com/rhasspy/piper/releases (piper_linux_x86_64.tar.gz)"
  echo "Extraia em ./piper e rode de novo."
  echo "Vozes em https://huggingface.co/rhasspy/piper-voices"
  exit 0
fi
[ -x "./piper/piper" ] && PIPER_BIN="./piper/piper"

mkdir -p "$DESTINO"
ONNX="$DESTINO/$VOZ.onnx"
JSON="$DESTINO/$VOZ.onnx.json"
if [ ! -f "$ONNX" ]; then
  if command -v wget >/dev/null 2>&1; then
    wget -q "$VOZ_URL/pt_BR-faber-medium.onnx" -O "$ONNX"
    wget -q "$VOZ_URL/pt_BR-faber-medium.onnx.json" -O "$JSON"
  else
    echo "wget não encontrado; baixe a voz manualmente para $DESTINO"
    exit 0
  fi
fi

for i in 1 2 3; do
  case $i in
    1) frase="Olá, este é um teste de síntese de voz local com Piper." ;;
    2) frase="A velocidade de inferência é medida pelo fator de tempo real." ;;
    3) frase="Piper roda em CPU comum, sem GPU e sem internet após o download." ;;
  esac
  saida="$DESTINO/frase-$i.wav"
  echo "=== frase $i ==="
  echo "$frase"
  echo "$frase" | "$PIPER_BIN" --model "$ONNX" --output_file "$saida" 2>&1 | tail -3
  ls -lh "$saida"
done
Como verificar
Rode echo "teste" | piper --model voz.onnx --output_file teste.wav e confira ls -lh teste.wav. Na medição acima, uma frase de três segundos gerou 142 KB. O log do piper imprime Real-time factor: 0.066, ou seja, a inferência levou 6,6% do tempo do áudio. Para checar o arquivo: ffprobe teste.wav ou file teste.wav.
Se der errado
command not found: piper: o binário não está no PATH ou não foi extraído. Causa: instalação incompleta. Correção: extraia o tar.gz e chame ./piper/piper, ou adicione a pasta ao PATH.
Arquivo .onnx.json faltando: o piper falha ao carregar a voz. Causa: download parcial. Correção: baixe os dois arquivos, .onnx e .onnx.json, da mesma pasta da voz no Hugging Face.
Áudio com cliques ou cortado: frase longa demais ou sem pontuação. Causa: o modelo perde a cadência em textos longos. Correção: divida em frases menores e use pontuação.
Piper ou serviço em nuvem
| Piper (local) | Serviço em nuvem | |
|---|---|---|
| Custo | gratuito | por caractere ou por minuto |
| Privacidade | o texto não sai da máquina | o texto é enviado para a API |
| Latência | offline, sem rede | depende da rede |
| Qualidade | boa para leitura, voz fixa | geralmente melhor, várias vozes |
| Setup | binário mais uma voz | chave de API |
Perguntas frequentes
Funciona em português? Sim. Há vozes pt_BR no repositório: cadu, edresson, faber e jeff, em qualidades low e medium.
Precisa de GPU? Não. O teste rodou em CPU comum, com voz carregando em cerca de 0,3 s.
Posso usar comercialmente? As vozes são MIT. O binário rhasspy/piper é MIT; a versão atual (OHF-Voice/piper1-gpl) é GPL-3.0. Confira a licença do binário que você distribuir.
Qual formato de saída? WAV em PCM. Para MP3 ou OGG, converta com ffmpeg -i saida.wav saida.mp3.
Quão rápido é? No teste, fator de tempo real de 0,06, ou seja, a síntese foi cerca de 15 vezes mais rápida que a duração do áudio. Frases longas levam mais, mas ainda abaixo de um segundo para textos de até duas linhas.
Vozes e idiomas
O repositório de vozes tem 35 idiomas. Para português brasileiro, quatro vozes: cadu, edresson, faber e jeff. As qualidades são low e medium. A qualidade low é mais rápida e menor (cerca de 20 MB), a medium soa mais natural e pesa cerca de 60 MB. Para um assistente que lê notificações, a low basta. Para audiobook, a medium é o mínimo.
A qualidade percebida depende mais do texto do que da voz. Pontuação, vírgulas e quebras de linha guiam a prosódia. Texto sem pontuação sai monótono. Texto com abreviações (Dr., Sr., km/h) sai errado, porque o modelo lê letra por letra. Expanda as abreviações antes de sintetizar.
Integrando com o resto da cadeia
Piper gera WAV. Para enviar por Telegram ou publicar na web, converta para OGG ou MP3 com ffmpeg: ffmpeg -i saida.wav -c:a libopus -b:a 24k saida.ogg. O Opus a 24 kbps mantém a inteligibilidade e reduz o arquivo em 10 vezes.
Para dublar um vídeo, gere o áudio frase por frase e monte a trilha com ffmpeg, ajustando a velocidade com atempo quando a frase sintetizada for mais longa que o espaço disponível. Para acessibilidade, combine com um transcritor: o mesmo texto que vai para o Piper pode ir para legenda.
Privacidade e custo
A vantagem central é que o texto não sai da máquina. Para textos sensíveis (documentos internos, transcrições de reunião, dados de clientes), isso importa mais do que a qualidade. O custo é zero depois do download, e não há cota, limite de requisições ou mudança de preço.
A desvantagem é que você mantém o binário e a voz atualizados. O piper parou de receber atualizações no repositório original; a continuação é o OHF-Voice/piper1-gpl. Se você precisar de suporte a longo prazo, acompanhe esse repositório.
Hardware
O teste rodou em CPU comum, sem GPU. A voz carregou em cerca de 0,3 s e a inferência foi 15 vezes mais rápida que o áudio. Para textos longos (um capítulo de livro), processe parágrafo por parágrafo e concatene os WAVs, porque a memória cresce com o tamanho do texto.
Em máquinas com pouca RAM, a voz medium (60 MB) mais o runtime (cerca de 30 MB) cabem sem problema. Não há necessidade de swap dedicado para isso.
Fontes
- rhasspy/piper, binário 1.2.0, licença MIT, desenvolvimento migrado para OHF-Voice/piper1-gpl (GPL-3.0).
- rhasspy/piper-voices, vozes em 35 idiomas, licença MIT.
Veja também rodar modelo na CPU com llama.cpp, custo por consumidor de IA e quantização de modelo: o que muda.