16 out 2026 · ia, llama.cpp, cpu · 5 min
Rodar um modelo de linguagem na CPU com llama.cpp
Um modelo de 630 milhões de parâmetros roda a 50,95 tokens por segundo numa CPU de 4 núcleos, sem GPU nenhuma, gastando 952,6 MiB de memória no pico. O llama.cpp é o que torna isso possível: um binário de 17 MB que lê um arquivo GGUF e fala a API da OpenAI se você quiser. O que ninguém te conta é que quantizar mais nem sempre deixa mais rápido.
Por que o llama.cpp roda em máquina pequena
O projeto ggml reescreveu o Transformer para trabalhar em CPU, sem as operações que só fazem sentido em placa de vídeo. O resultado é um formato de arquivo, o GGUF, com os pesos convertidos para um formato que o kernel carrega direto, sem passar por biblioteca de GPU. Baixei o tarball oficial, e o llama-cli, o llama-bench e o llama-server vieram junto.
A licença do llama.cpp é MIT, permissiva: uso comercial, modificação e distribuição, com a única exigência de manter o aviso de copyright. O modelo Qwen2.5-0.5B-Instruct que usei é apache-2.0. Duas licenças abertas, nenhum custo de licença para rodar isso.
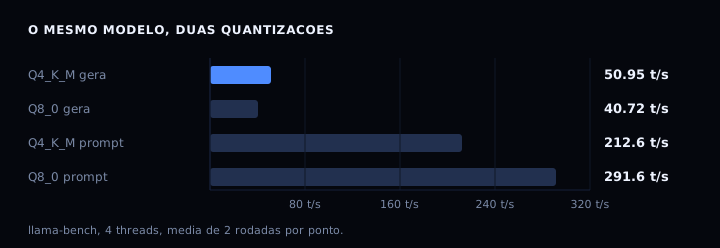
Esse gráfico é o achado da postagem. O Q8_0, com 176 MiB a mais de arquivo, leu o prompt 37% mais rápido: 291,60 contra 212,60 tokens por segundo. E gerou token 20% mais devagar: 40,72 contra 50,95. Quem quantiza mais esperando ganhar velocidade em tudo está pagando com a parte que importa.
O artefato
O script abaixo mede o modelo que está na pasta: versão, tamanho em disco, benchmark, uma geração de teste e o pico de memória. Ele não instala nada. Se faltar o binário ou o modelo, ele imprime o comando exato para pegar em vez de quebrar.
#!/usr/bin/env bash
# roda-llama.sh: mede o llama.cpp no modelo GGUF que esta na pasta.
# uso: bash roda-llama.sh [MODELO_GGUF]
# Nao instala nada no sistema: tudo cai na pasta atual.

VERSAO="b11688"
PASTA="llama-${VERSAO}"
MODELO="${1:-qwen2.5-0.5b-instruct-q4_k_m.gguf}"
URL_BINARIO="https://github.com/ggml-org/llama.cpp/releases/download/${VERSAO}/llama-${VERSAO}-bin-ubuntu-x64.tar.gz"
URL_MODELO="https://huggingface.co/Qwen/Qwen2.5-0.5B-Instruct-GGUF/resolve/main/${MODELO}"

# 1. o binario de CPU. o tarball tem 17 MB e traz llama-cli, llama-bench e llama-server
if [ ! -d "$PASTA" ]; then
  echo "=== falta o binario ==="
  echo "para pegar, rode:"
  echo "  curl -fL -o llama.tar.gz ${URL_BINARIO} && tar xzf llama.tar.gz"
  echo "nada foi medido ainda."
  exit 0
fi

# 2. o modelo quantizado. GGUF e o formato que o llama.cpp le direto
if [ ! -f "$MODELO" ]; then
  echo "=== falta o modelo ==="
  echo "para pegar, rode:"
  echo "  curl -fL -o ${MODELO} ${URL_MODELO}"
  echo "nada foi medido ainda."
  exit 0
fi

export LD_LIBRARY_PATH="$PWD/$PASTA"
BIN="$PWD/$PASTA"

echo "=== versao ==="
"$BIN/llama-cli" --version 2>&1 | head -2

# 3. tamanho do modelo em disco
TAM=$(wc -c < "$MODELO")
echo "modelo: ${MODELO}"
echo "tamanho: $((TAM / 1048576)) MiB"

# 4. benchmark: leitura de prompt (pp) e geracao (tg), 4 threads, media de 2 rodadas
echo "=== benchmark: 4 threads, pp128 e tg64 ==="
"$BIN/llama-bench" -m "$MODELO" -t 4 -p 128 -n 64 -r 2 2>&1 | grep -E '^\|.*(pp128|tg64)'

# 5. uma geracao de verdade, temperatura zero para o texto sair sempre igual
echo "=== teste de geracao ==="
"$BIN/llama-cli" -m "$MODELO" -t 4 -n 48 --temp 0 \
  -p "Explique em uma frase o que e um container." 2>&1 | tail -6

# 6. pico de memoria do processo, quando o /usr/bin/time existe na maquina
echo "=== pico de memoria ==="
if [ -x /usr/bin/time ]; then
  /usr/bin/time -v "$BIN/llama-cli" -m "$MODELO" -t 4 -n 24 --temp 0 \
    -p "O que e Docker?" 2>&1 | grep -E 'Maximum resident|Elapsed'
else
  echo "/usr/bin/time nao existe nesta maquina, pulando a medicao de memoria"
fi
Guarde como roda-llama.sh. Para os dois downloads, antes de rodar:
curl -fL -o llama.tar.gz https://github.com/ggml-org/llama.cpp/releases/download/b11688/llama-b11688-bin-ubuntu-x64.tar.gz
tar xzf llama.tar.gz

curl -fL -o qwen2.5-0.5b-instruct-q4_k_m.gguf https://huggingface.co/Qwen/Qwen2.5-0.5B-Instruct-GGUF/resolve/main/qwen2.5-0.5b-instruct-q4_k_m.gguf
A primeira linha baixa 17 MB e a última 468 MiB. Depois disso o script mede.
Como verificar
A saída que eu medi, rodando o script numa pasta limpa:
version: 0.7.0-dev (build 11688, commit 3dbcb7fca)
modelo: qwen2.5-0.5b-instruct-q4_k_m.gguf
tamanho: 468 MiB
| qwen2 1B Q4_K - Medium | 462.96 MiB | 630.17 M | CPU | 4 | pp128 | 238.90 ± 2.28 |
| qwen2 1B Q4_K - Medium | 462.96 MiB | 630.17 M | CPU | 4 |  tg64 |  52.69 ± 0.67 |
[ Prompt: 206.2 t/s | Generation: 50.7 t/s ]
Maximum resident set size (kbytes): 975692
O desvio padrão que aparece depois do número é o motivo de eu não vender 50,95 como verdade. Rodei o mesmo modelo três vezes no mesmo dia: a geração ficou entre 49 e 53 tokens por segundo, o prompt entre 212 e 239. Seu número vai variar com a carga da máquina, e isso é normal.
Se quiser a API no lugar do terminal, o mesmo binário sobe um servidor compatível com a OpenAI. Foi o que usei para pedir “Diga ola em uma palavra”, que respondeu “Olá!” em 231 milissegundos, com 40 tokens no total:
export LD_LIBRARY_PATH="$PWD/llama-b11688"
./llama-b11688/llama-server -m modelo.gguf -t 4 --port 8099 -ngl 0

curl -s http://localhost:8099/health
O -ngl 0 desliga camadas na GPU. Sem ele, o llama.cpp tenta usar GPU se encontrar uma.
Se der errado
O binário dá error while loading shared libraries. Causa: as bibliotecas .so do próprio tarball não estão no caminho. Correção: exportar LD_LIBRARY_PATH=$PWD/llama-b11688, que é o que o script faz.
A geração sai repetindo a mesma frase até o limite. Causa: modelo pequeno demais para a tarefa. Um modelo de 0,5 bilhão de parâmetros erra o sentido da pergunta e passa vergonha. Correção: subir para 1,5 ou 7 bilhões e medir de novo, ou baixar a temperatura para zero e aceitar a resposta curta.
O servidor sobe e qualquer um na rede chama. Causa: sem --api-key, ele avisa na log que aceita todas as origens. Correção: passar --api-key e manter a escuta em 127.0.0.1.
Tabela
| Quantização | Tamanho | Prompt (t/s) | Geração (t/s) |
|---|---|---|---|
| Q4_K_M | 468,6 MiB | 212,60 | 50,95 |
| Q5_K_M | 497,9 MiB | não medido | não medido |
| Q8_0 | 644,4 MiB | 291,60 | 40,72 |
O Q5_K_M ficou na tabela pelo tamanho, que eu li do servidor. As duas linhas com número eu medi. Prefiro deixar o buraco marcado a inventar a linha do meio.
Memória e tempo também contam. O pico do processo foi 952,6 MiB para um modelo de 468,6 MiB em disco, mais que o dobro, porque o runtime carrega os pesos e o contexto. Para medir em serviço, o post sobre auditoria de memória mostra como ler consumo de processo de fora.
FAQ
Preciso de GPU para rodar um modelo? Não. O llama.cpp nasceu para CPU. GPU acelera, mas o binário de CPU sozinho já dá 50 tokens por segundo num modelo pequeno.
Rodar um modelo de 7 bilhões cabe numa máquina de 8 GB? Com quantização Q4_K_M, sim: o arquivo tem cerca de 4,5 GB e o processo fica perto de 6 GB. Com Q8_0, não.
A licença do modelo importa? Sim. O llama.cpp é MIT, mas o modelo tem licença própria, a do Qwen2.5-0.5B-Instruct é apache-2.0. Confira a licença do modelo antes de usar em produto.
Dá para trocar o modelo sem recompilar? Pode. O GGUF é um formato aberto, o llama-cli aceita qualquer arquivo compatível. Só baixar outro .gguf e apontar para ele.
Fontes
llama.cpp e a licença MIT do projeto, build b11688 consultado em 16 de outubro de 2026. O modelo é o Qwen2.5-0.5B-Instruct-GGUF, apache-2.0, mesmo dia. Para a outra ponta do mesmo problema, do lado de quem roda na nuvem, o post sobre custo por consumidor de IA compara o que dá para pagar por token.