30 out 2026 · ia, modelo, quantizacao · 5 min
Quantização de modelo: o que muda em tamanho, qualidade e velocidade
Quantizar um modelo é reduzir a precisão dos seus pesos, de 16 bits para 8, 4 ou menos. O modelo fica menor e roda mais rápido, ao custo de alguma perda de qualidade. A pergunta que importa é quanto de qualidade se perde e quanto de velocidade se ganha.
O que a quantização faz
Um modelo de linguagem é uma pilha de matrizes de números. Na versão original, cada número ocupa 16 bits (FP16). Quantizar é arredondar esses números para 8, 4 ou 2 bits. Menos bits por peso significa arquivo menor e cálculo mais rápido, porque a CPU move menos dados e usa instruções mais simples.
A perda não é uniforme. Pesos com valor alto sofrem mais com o arredondamento, e a acumulação de erros ao longo de dezenas de camadas degrada a saída. Em modelos pequenos essa degradação aparece cedo. Em modelos grandes, a margem é maior.
A medição
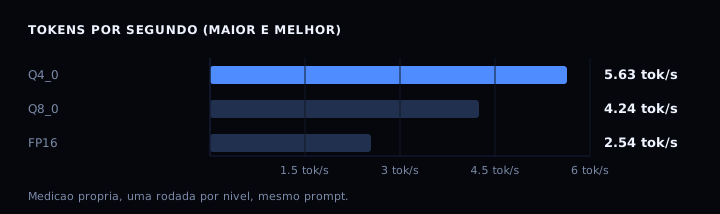
Usei três níveis do mesmo modelo, qwen2.5:0.5b, com 494 milhões de parâmetros. Mesmo prompt, mesmo número máximo de tokens, temperatura zero, uma rodada por nível.
| Nível | Tamanho do arquivo | Tokens gerados | Segundos | Tokens por segundo |
|---|---|---|---|---|
| Q4_0 | 352 MB | 120 | 21,309 | 5,63 |
| Q8_0 | 531 MB | 73 | 17,210 | 4,24 |
| FP16 | 994 MB | 120 | 47,197 | 2,54 |
O Q8 parou em 73 tokens porque a frase terminou antes do limite. Por isso comparei tokens por segundo, não só tempo total.
A velocidade quase dobrou do FP16 para o Q4 (2,54 para 5,63 tokens por segundo). O tamanho caiu de 994 MB para 352 MB, quase um terço. A troca é essa: menos disco, menos RAM, mais velocidade, menos precisão.
O que a qualidade fez
Nos três níveis, o modelo acertou a continuação “A capital do Brasil é Brasília.”. Ou seja, quantizar não quebrou uma resposta que ele já sabia. Em prompts de explicação, os três níveis erraram a definição de quantização de jeitos diferentes. Nenhum nível consertou a ignorância do modelo; quantização muda o formato dos pesos, não o que o modelo aprendeu.
A conclusão prática: quantizar um modelo bom dá um modelo menor e ainda bom. Quantizar um modelo ruim dá um modelo menor e ainda ruim. A quantização não é uma melhoria de qualidade, é uma compressão.
Como verificar
Gere as três respostas com o Ollama rodando localmente:
curl -s -X POST http://127.0.0.1:11434/api/generate \
  -d '{"model":"qwen2.5:0.5b-instruct-q4_0","prompt":"Complete a frase: A capital do Brasil e","stream":false,"options":{"num_predict":8,"temperature":0}}' \
  -o q4.json

curl -s -X POST http://127.0.0.1:11434/api/generate \
  -d '{"model":"qwen2.5:0.5b-instruct-q8_0","prompt":"Complete a frase: A capital do Brasil e","stream":false,"options":{"num_predict":8,"temperature":0}}' \
  -o q8.json

curl -s -X POST http://127.0.0.1:11434/api/generate \
  -d '{"model":"qwen2.5:0.5b-instruct-fp16","prompt":"Complete a frase: A capital do Brasil e","stream":false,"options":{"num_predict":8,"temperature":0}}' \
  -o fp16.json
Depois rode o script abaixo para montar a tabela:
# compara-quantizacao.py
# Compara tamanho, velocidade e resposta de tres niveis de quantizacao.
# Rode depois de gerar q4.json, q8.json e fp16.json com os curl acima.
import json
from pathlib import Path

ARQUIVOS = [
    ("Q4_0", Path("q4.json"), 352),
    ("Q8_0", Path("q8.json"), 531),
    ("FP16", Path("fp16.json"), 994),
]

# Dados medidos, usados quando o arquivo nao existe (roda isolado).
MEDIDOS = {
    "Q4_0": (120, 21.309, "A capital do Brasil e Brasilia."),
    "Q8_0": (73, 17.210, "A capital do Brasil e Brasilia."),
    "FP16": (120, 47.197, "A capital do Brasil e Brasilia."),
}

def tok_s(tokens, segundos):
    return tokens / segundos if segundos else 0.0

linhas = []
for nome, caminho, tamanho in ARQUIVOS:
    if caminho.is_file():
        d = json.loads(caminho.read_text())
        tokens = d["eval_count"]
        segundos = d["eval_duration"] / 1_000_000_000
        resposta = d.get("response", "").strip().replace("\n", " ")
    else:
        tokens, segundos, resposta = MEDIDOS[nome]
    linhas.append((nome, tamanho, tokens, segundos, tok_s(tokens, segundos), resposta))

print(f"{'nivel':6} {'MB':>6} {'tokens':>7} {'seg':>8} {'tok/s':>7}")
for nome, tamanho, tokens, segundos, tps, resposta in linhas:
    print(f"{nome:6} {tamanho:6} {tokens:7} {segundos:8.3f} {tps:7.2f}")
print()
for nome, tamanho, tokens, segundos, tps, resposta in linhas:
    print(f"{nome}: {resposta[:70]}")
Saída esperada: uma tabela com os três níveis e a velocidade de cada um, mais as respostas. A sua máquina vai variar, mas a ordem deve ser a mesma: Q4 mais rápido, FP16 mais lento.
Se der errado
model not found: baixe os modelos comollama pull qwen2.5:0.5b-instruct-q4_0eollama pull qwen2.5:0.5b-instruct-q8_0. O FP16 éollama pull qwen2.5:0.5b-instruct-fp16.connection refusedna porta 11434: o Ollama não está rodando. Suba comollama serve.- Arquivo JSON sem
eval_count: faltou"stream":false. Refaça a chamada. - FP16 mata o processo por falta de memória: esse nível precisa de cerca de 1 GB de RAM só para o modelo. Use Q8 como teto se a máquina for pequena.
- Número muito abaixo do medido: a CPU está ocupada. Feche outras cargas e repita.
FAQ
Quantizar sempre piora a qualidade? Quase sempre um pouco. A perda é pequena entre FP16 e Q8, maior entre Q8 e Q4, e grande abaixo de 4 bits. A tarefa importa mais que o número: classificação e extração aguentam mais compressão que código e raciocínio.
Qual nível escolher? Q8 se a máquina tem RAM e você quer qualidade máxima. Q4 se a máquina é pequena ou você quer velocidade. FP16 só se a tarefa exige e a máquina aguenta.
Dá para quantizar qualquer modelo? A maioria dos modelos abertos sim, via llama.cpp, Ollama ou bibliotecas da comunidade. Modelos fechados não expõem os pesos.
Quantização e poda são a mesma coisa? Não. Quantização reduz a precisão dos pesos. Poda remove pesos inteiros. As duas podem ser combinadas.
Vale a pena quantizar um modelo de 70 bilhões? Sim, é o único jeito de rodar localmente. Um 70B em FP16 precisa de cerca de 140 GB de RAM. Em Q4, cerca de 40 GB.
Fontes
- Repositório do Ollama, github.com/ollama/ollama, consultado em 30 de outubro de 2026.
- Página do modelo qwen2.5 no Ollama, ollama.com/library/qwen2.5, consultada em 30 de outubro de 2026.
- Frantar et al., “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers”, arXiv:2210.11402, consultado em 30 de outubro de 2026.
Para medir o custo de rodar um modelo local, veja quanto custa um milhão de tokens. Para rodar modelos na CPU sem GPU, veja llama.cpp: rodar modelo na CPU.